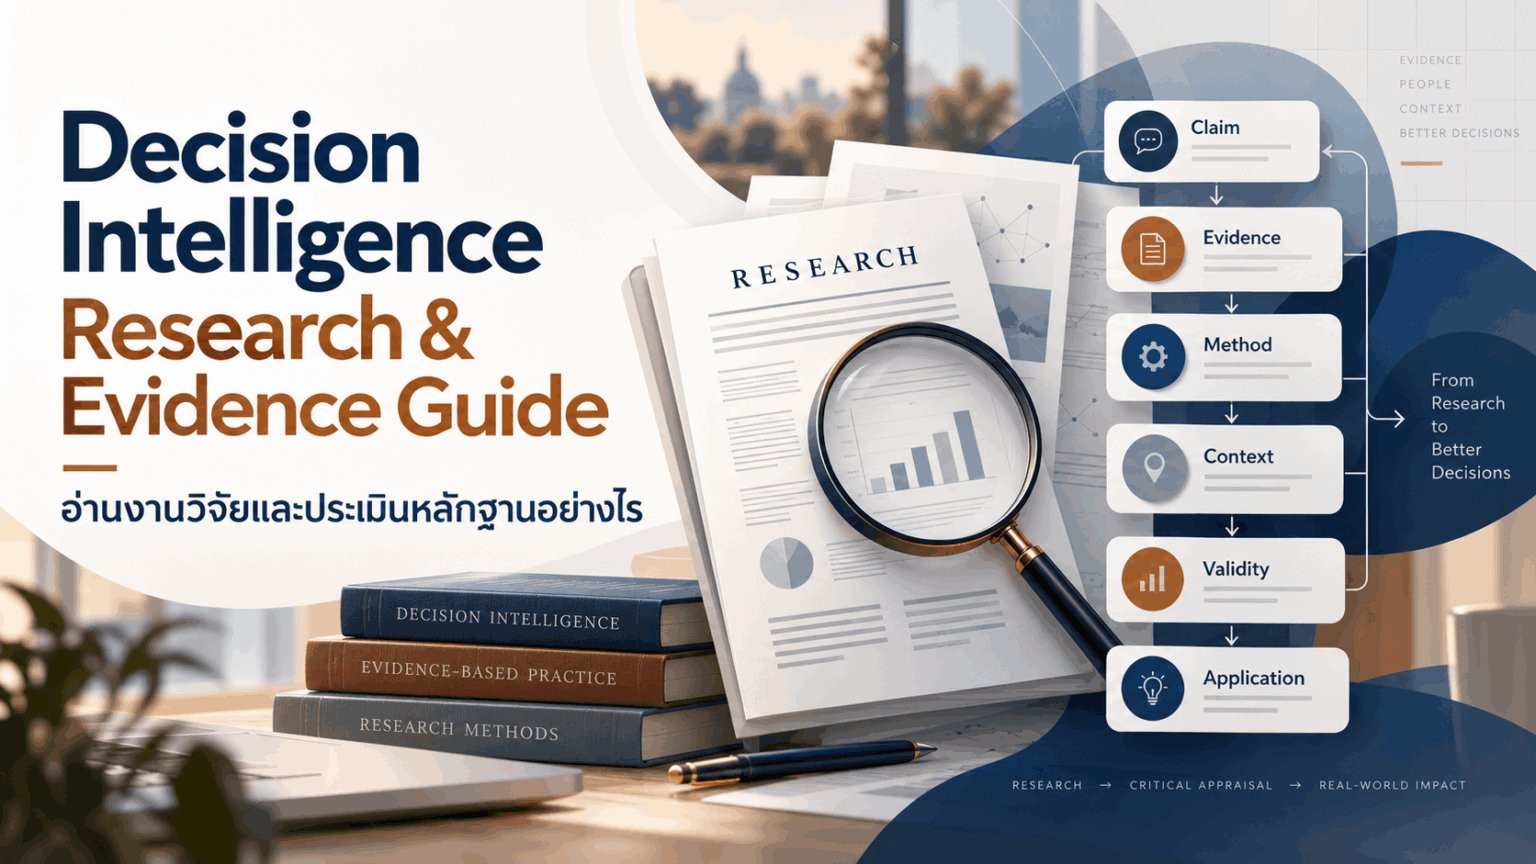
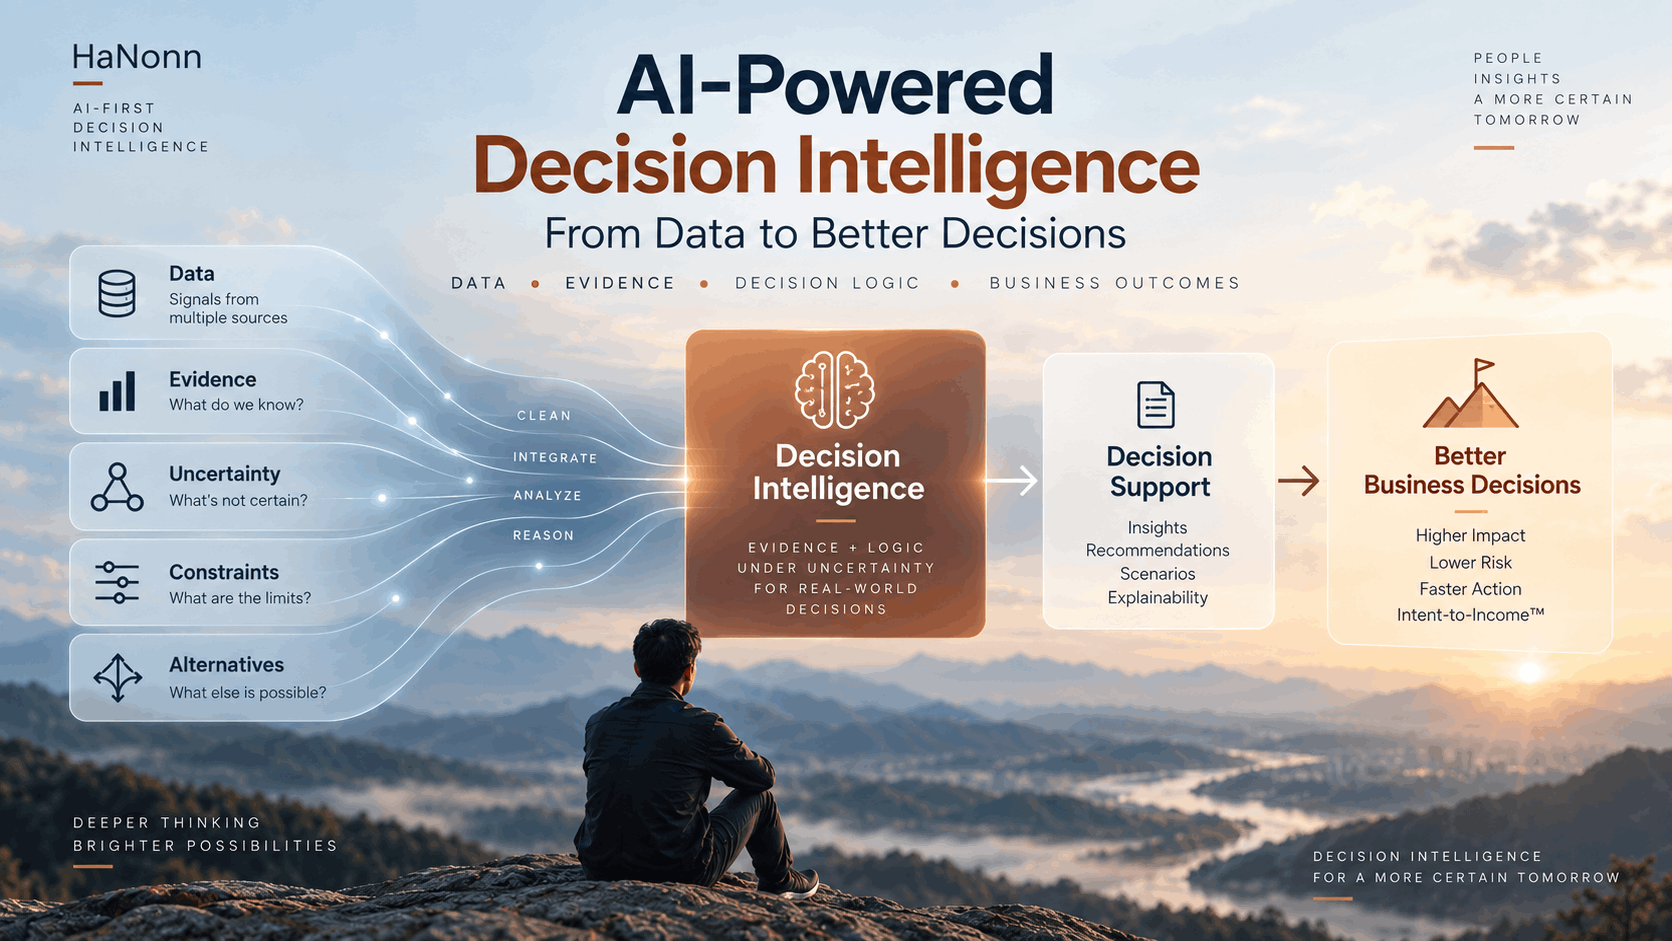
Research & Evidence ใน Decision Intelligence ช่วยให้เราประเมินว่า Claim ที่ใช้ประกอบการตัดสินใจ มีหลักฐานใดรองรับ หลักฐานได้มาอย่างไร และรองรับข้อสรุปได้เพียงใด
จุดสำคัญจึงไม่ใช่ว่า “มีงานวิจัยรองรับหรือไม่” แต่ควรตรวจความสอดคล้องระหว่าง Claim กับ Evidence
CLAIM–EVIDENCE CHECK
CLAIM กำลังอ้างอะไร
→
QUESTION ต้องตอบคำถามอะไร
→
METHOD ศึกษาอย่างไร
→
EVIDENCE พบอะไรจริง
→
BOUNDARY สรุปได้ไกลแค่ไหน
→
APPLICATION นำไปใช้กับอะไร
EVIDENCE FOR DECISIONS
Evidence ที่ใช้ประกอบการตัดสินใจอาจมาจากงานวิจัย ข้อมูลการดำเนินงาน ความเชี่ยวชาญ และมุมมองของผู้มีส่วนได้ส่วนเสีย โดยต้องประเมินทั้งความน่าเชื่อถือและความเกี่ยวข้องกับ Claim และ Decision Context
EVIDENCE AROUND THE DECISION
SCIENTIFIC RESEARCH
งานวิจัยบอกอะไรเรา
Theory, empirical studies และ research synthesis ช่วยอธิบายแนวคิด ข้อค้นพบ และเงื่อนไขของผลที่ศึกษา
ORGANIZATIONAL / OPERATIONAL
ข้อมูลจากบริบทจริงบอกอะไร
Operational data, historical outcomes, process metrics และข้อมูลภายใน ที่ช่วยให้เห็นสิ่งที่เกิดขึ้นจริง
PROFESSIONAL & DOMAIN JUDGMENT
ผู้เชี่ยวชาญรู้อะไรจากประสบการณ์
Domain knowledge, professional experience และความเข้าใจบริบท ช่วยประเมินความเป็นไปได้ ข้อจำกัด และความเหมาะสมของ Evidence อื่น
STAKEHOLDER EVIDENCE
ผู้ที่ได้รับผลกระทบให้ข้อมูลอะไร
Needs, values, concerns, preferences และประสบการณ์ของผู้มีส่วนเกี่ยวข้อง ช่วยให้เห็นสิ่งที่ข้อมูลเชิงเทคนิคอาจไม่ครอบคลุม
ตัวอย่างสมมติ: ร้านขายรองเท้าออนไลน์ควรเพิ่มเครื่องมือช่วยเลือกไซซ์
Scientific Research
ศึกษางานวิจัยว่า ข้อมูลช่วยเลือกสินค้าและความไม่แน่นอนส่งผลต่อการตัดสินใจอย่างไร
Organizational Evidence
ตรวจอัตราการคืนสินค้า เหตุผลการคืน และคำถามเกี่ยวกับไซซ์จากลูกค้า
Professional Expertise
ตรวจมาตรฐานการวัดเท้า ความแตกต่างของไซซ์แต่ละรุ่น และความเป็นไปได้ของเครื่องมือ
Stakeholder Evidence
สอบถามว่าลูกค้าเลือกไซซ์อย่างไร กังวลเรื่องใด และต้องการข้อมูลอะไรเพิ่มเติม
Key Insight: หลักฐานแต่ละแหล่งช่วยตอบคำถามต่างกัน การนำมาพิจารณาร่วมกัน จะช่วยประเมินความจำเป็นและแนวทางออกแบบเครื่องมือ
เพิ่มเติม: Evidence-Based Decision Making และ AI as a Socio-technical System
Evidence-Based Decision Making
Center for Evidence-Based Management (CEBMa) เสนอให้ใช้หลักฐานจากหลายแหล่งอย่างมีวิจารณญาณ โดยพิจารณาคุณภาพและความเกี่ยวข้องของหลักฐานก่อนนำไปใช้ตัดสินใจ
CEBMa — Evidence-Based Decision Making →
Evidence-based decision making · Multiple evidence sources
AI as a Socio-technical System
NIST AI Risk Management Framework ระบุว่า AI systems มีลักษณะ socio-technical: ความเสี่ยงและประโยชน์สามารถเกิดจาก ปฏิสัมพันธ์ระหว่าง องค์ประกอบทางเทคนิค วิธีที่ระบบถูกใช้ ผู้ที่ใช้งาน และบริบททางสังคมหรือการปฏิบัติงาน การประเมิน AI จึงไม่ควรหยุดอยู่ที่ Model Metrics เพียงอย่างเดียว
NIST AI RMF — Measure →
AI Risk Management Framework · Measurement · Socio-technical context
CLAIM–EVIDENCE FIT
Claim แต่ละประเภทต้องการหลักฐานต่างกัน เช่น หลักฐานว่าระบบทำงานตามที่ออกแบบ ไม่ได้ยืนยันว่าผู้ใช้ตัดสินใจดีขึ้น หรือเกิดผลลัพธ์จริง
CLAIM–EVIDENCE MAP
CONCEPTUAL
Conceptual Claim
แนวคิด Framework นิยาม มีฐานทางทฤษฎีและเหตุผลรองรับหรือไม่
EVIDENCE FIT
Theory, literature synthesis, conceptual analysis และงานที่พัฒนา Framework
Conceptual support ≠ real-world effectiveness
DESIGN
Design Claim
Architecture, system หรือ interface ถูกออกแบบให้ทำหน้าที่บางอย่างอย่างไร
EVIDENCE FIT
Design rationale, requirements, artifact inspection, prototype / expert review
Design evidence ≠ user success
INTERACTION
Interaction Claim
ผู้ใช้เข้าใจ ใช้งาน หรือโต้ตอบกับระบบได้อย่างไร
EVIDENCE FIT
Usability study, task evaluation, HCI study และข้อมูลจากผู้ใช้
Usability ≠ better Decision
BEHAVIOR
Behavioral Claim
ระบบหรือ Intervention เปลี่ยน Judgment หรือพฤติกรรมของผู้ใช้หรือไม่
EVIDENCE FIT
Behavioral observation สำหรับศึกษาพฤติกรรม และ controlled comparison กับ Baseline เมื่อต้องการประเมินผลของ Intervention
Behavior change ≠ beneficial change
DECISION
Decision Claim
ระบบช่วยให้มนุษย์ตัดสินใจได้ดีขึ้นตามเกณฑ์ที่กำหนดไว้หรือไม่
EVIDENCE FIT
Comparative evaluation และ Decision metrics ที่ตรงกับบริบท
Decision performance ≠ business impact
REAL-WORLD / USE
Operational Claim
ระบบทำงานได้ตามข้อกำหนด มีความน่าเชื่อถือ และจัดการข้อผิดพลาดได้เพียงใดเมื่อใช้งานจริง
EVIDENCE FIT
Field study, pilot, production evaluation, longitudinal monitoring
Operational performance
OUTCOME / IMPACT
Outcome / Impact Claim
เกิดผลต่อผู้ใช้ ธุรกิจ องค์กร หรือ Outcome ที่สำคัญหรือไม่
EVIDENCE FIT
Outcome measurement, field data และ causal / quasi-causal evaluation เมื่อ Claim ต้องการสรุปเหตุและผล
Association ≠ causation
EXAMPLE · SAME SYSTEM · DIFFERENT CLAIMS
Design
ระบบแสดง Evidence และ Trade-offs → ตรวจสอบ Artifact หรือ Prototype
Interaction
ผู้ใช้เข้าใจ Evidence และ Trade-offs → ทดสอบความเข้าใจกับผู้ใช้
Decision
ผู้ใช้ตัดสินใจได้ดีขึ้น → ประเมิน Decision Metrics เทียบกับ Baseline
Impact
ระบบทำให้ Business Outcome ดีขึ้น → ประเมิน Outcome อธิบายทางเลือกอย่างเหมาะสม
เพิ่มเติม: Design Evidence และ Behavioral Evidence ต่างกันอย่างไร
Hevner et al. (2004) อธิบายบทบาทของ Design Science ในการสร้างและประเมิน Artifacts และ Behavioral Science ในการพัฒนาและตรวจสอบทฤษฎีที่อธิบายหรือคาดการณ์ปรากฏการณ์ การประเมิน Artifact เพียงด้านเดียวจึงไม่เพียงพอที่จะยืนยันผลต่อผู้ใช้หรือ Outcomes
RESEARCH DESIGN & INFERENCE
การเลือก Research Design ต้องเริ่มจากคำถามที่ต้องการตอบ เพราะหลักฐานที่บอกว่า “ผู้ใช้พบปัญหาอะไร” อาจยังไม่เพียงพอที่จะยืนยันว่า “วิธีแก้ปัญหานั้นได้ผลจริง” สิ่งสำคัญคือแยกให้ออกว่างานศึกษาพบอะไร และสามารถสรุปอะไรจากผลนั้นได้บ้าง
RESEARCH QUESTION → DESIGN → DEFENSIBLE CONCLUSION
ตัวอย่างสมมติ: ร้านรองเท้าออนไลน์ประเมินการทำเครื่องมือช่วยเลือกไซซ์
ลูกค้าพบปัญหาอะไรในการเลือกไซซ์?
METHOD
User Interviews, วิเคราะห์คำถามและข้อร้องเรียน
CONCLUSION
ระบุปัญหาในกลุ่มศึกษา (ยังไม่ยืนยันความชุกหรือสาเหตุที่แท้จริง)
ลูกค้าเข้าใจคำแนะนำไซซ์หรือไม่?
METHOD
Usability Study, Task-based Evaluation
CONCLUSION
ประเมินความเข้าใจและการใช้งาน (สรุปว่าช่วยให้เลือกไซซ์ดีขึ้นไม่ได้ หากไม่ได้วัดผลตรงนั้น)
เครื่องมือช่วยให้เลือกไซซ์ได้เหมาะสมขึ้นหรือไม่?
METHOD
Randomized Controlled Comparison (เทียบ Baseline)
CONCLUSION
วัดผลตามเกณฑ์ภายใต้เงื่อนไขทดลอง (ความน่าเชื่อถือขึ้นกับ Design & Measurement)
เมื่อใช้งานจริง ผลลัพธ์เป็นอย่างไร?
METHOD
Field Evaluation, Outcome Monitoring
CONCLUSION
ตรวจผลใช้งานจริง เช่น การคืนสินค้า (แต่เทียบแค่ก่อน-หลัง ยังฟันธงไม่ได้ว่ามาจากเครื่องมือ)
ผลยังคงอยู่เมื่อเปลี่ยนสินค้าหรือผู้ใช้หรือไม่?
METHOD
Cross-context Evaluation, Replication & Longitudinal Study
CONCLUSION
วัดความสม่ำเสมอข้ามกลุ่มผู้ใช้/สินค้า/เวลา (ขอบเขตการอ้างอิงจำกัดตามบริบทที่ทดสอบ)
Research Design ต้องสอดคล้องกับ Claim ที่ต้องการตรวจสอบ และข้อสรุปต้องไม่เกินสิ่งที่ Method, Measurement และ Comparator รองรับ
เพิ่มเติม: Causal Inference และ Controlled Experiments
Experimental & Quasi-experimental Designs
Shadish, Cook และ Campbell (2002) อธิบายการออกแบบการทดลอง การประเมิน Causal Inference และการนำผลไปใช้ต่างบริบท โดยเน้นว่า ความน่าเชื่อถือของข้อสรุปขึ้นอยู่กับ Research Design, Validity และคำอธิบายทางเลือกที่ต้องพิจารณา
Research Design · Causal Inference · Validity · Generalization
Controlled Experiments on the Web
Kohavi และคณะ (2009) นำเสนอหลักการและประสบการณ์จากการทดลองออนไลน์ เช่น A/B Testing เพื่อประเมินผลของการเปลี่ยนแปลงระบบ โดยชี้ให้เห็นความสำคัญของ Randomization, Sample Size, Statistical Power และข้อจำกัดในการดำเนินการทดลองจริง
Data Mining and Knowledge Discovery, 18, 140–181 · A/B Testing · Experimental Design
VALIDITY LENS
งานวิจัยที่ออกแบบดีต้องถูกตรวจสอบความน่าเชื่อถือทั้ง 4 มิติ (สิ่งที่วัด, สถิติ, เหตุผล, บริบท) เพราะหลักฐานที่แข็งแรงในมิติหนึ่ง อาจมีข้อจำกัดในมิติอื่น
FOUR VALIDITY LENSES
CONSTRUCT VALIDITY
สิ่งที่วัดตรงกับ Construct จริงหรือไม่?
ตรวจว่าแนวคิด (เช่น Trust หรือ Decision Quality) ถูกนิยามและแปลงเป็นตัวแปรประเมินผลได้ถูกต้องแค่ไหน
ตรวจ: Operational Definition, Measurement & Construct Fit
STATISTICAL CONCLUSION
ผลลัพธ์มีขนาดและความไม่แน่นอนเท่าใด?
Statistical Significance อย่างเดียวไม่พอ ต้องประเมินขนาดผลกระทบ ความคลาดเคลื่อน และความสมบูรณ์ของข้อมูล
ตรวจ: Effect Size, Confidence Interval, Sample & Power
INTERNAL VALIDITY
มีหลักฐานพอตัดคำอธิบายอื่นทิ้งหรือไม่?
ตรวจว่าดีไซน์วิจัยสามารถแยกผลของตัวแปรหลัก ออกจากปัจจัยแทรกซ้อน (Confounding) ได้ขาดเพียงใด
ตรวจ: Comparator, Group Assignment & Confounding
EXTERNAL VALIDITY
ผลนี้นำไปใช้กับผู้ใช้หรือบริบทอื่นได้ไหม?
ประเมินว่าผลลัพธ์สามารถครอบคลุมไปถึงผู้ใช้, หน้าที่ (Task) หรือสภาพแวดล้อมที่ต่างจากงานวิจัยเดิมได้แค่ไหน
ตรวจ: Population, Task, Setting & Generalizability
RESEARCH AUDIT · BUÇINCA ET AL. (2021)
To Trust or to Think: Cognitive Forcing Functions Can Reduce Overreliance on AI
ทดลอง 199 คน เทียบ Cognitive Forcing 3 แบบ, Explainable AI 2 แบบ และ No-AI Baseline
ผลลัพธ์: Cognitive Forcing ลด Over-reliance ได้ดีกว่า แต่แลกมาด้วยความพึงพอใจที่ลดลง และได้ประโยชน์ต่างกันไปตามระดับ Need for Cognition ของแต่ละบุคคล
Construct
งานนี้แยกการวัด “พฤติกรรมทำตาม AI ที่ผิด ” ออกจาก “ความเชื่อมั่น ” ได้ชัดเจนเพียงใด?
Statistical
นอกจากค่า Significant ผลต่างมี Effect Size เท่าใด? และความคลาดเคลื่อนสูงหรือไม่เมื่อพิจารณาขนาด Sample?
Internal
ดีไซน์นี้แยกผลของ Cognitive Forcing ออกจากความต่างของผู้เข้าร่วมและปัจจัยแทรกซ้อน ได้รัดกุมเพียงใด?
External
Task ทดลองใกล้เคียงกับสถานการณ์ลูกค้าจริง หรือไม่? ตัวแปรกลุ่มเป้าหมายมีผลต่อการใช้งานจริงหรือไม่?
Evidence Boundary
ผลศึกษายืนยันว่า Cognitive Forcing ลด Over-reliance ได้ในบริบททดลอง แต่ไม่รับประกันว่าจะเพิ่มคุณภาพการตัดสินใจ (Decision Quality) เสมอไปในทุกสถานการณ์
REFERENCES Sources & Empirical Research
APPLICABILITY & GENERALIZATION
ผลวิจัยที่น่าเชื่อถือในบริบทหนึ่ง อาจยังนำมาใช้กับ Decision อื่นๆ โดยตรงไม่ได้ สิ่งสำคัญคือ ต้องประเมินว่า ความแตกต่างระหว่างบริบทเดิม กับบริบทที่จะนำไปใช้ อาจทำให้ผลลัพธ์เปลี่ยนไปหรือไม่
FROM RESEARCH CONTEXT TO DECISION CONTEXT
STUDY CONTEXT
งานเดิมศึกษาอะไร
ใครเข้าร่วม ทำ Task หรือ Decision อะไร อยู่ใน Setting แบบใด เปรียบเทียบกับอะไร
CONTEXT FIT
อะไรตรงกัน และอะไรต่างกัน
WHO
TASK
CONTEXT
COMPARATOR
INTERVENTION / AI SUPPORT
OUTCOME
TARGET DECISION CONTEXT
เรากำลังจะใช้ผลกับอะไร
Decision จริงของเรา ผู้ใช้จริง
APPLIED RESEARCH TRANSFER · BUÇINCA ET AL. (2021)
Research Finding
Cognitive Forcing ช่วยลด Over-reliance ได้ดีกว่าคำอธิบาย AI ทั่วไป แต่มี Trade-off ด้านประสบการณ์ผู้ใช้
Target Decision
การใช้ AI Recommendation ช่วยลูกค้าประเมินทางเลือกสินค้าอย่างมีวิจารณญาณ
Context Gap
Task ทดลองอาจต่างจากการซื้อจริง ทั้งด้านแรงจูงใจ ความเสี่ยง Interaction และ Outcome
Application / Hypothesis
ทดสอบ Cognitive Forcing เป็น Design Hypothesis ประเมิน Appropriate Reliance, Decision Quality และภาระใช้งาน
เพิ่มเติม: Directness, Indirectness และ Applicability
GRADE ใช้หลัก Indirectness เพื่อประเมินว่าหลักฐานตรงกับ Population, Intervention, Comparator และ Outcome ของคำถามเป้าหมายเพียงใด โดยพิจารณาว่าความแตกต่างนั้นอาจส่งผลต่อข้อสรุปหรือไม่ แนวคิดนี้มาจากการประเมินหลักฐานด้านสุขภาพ และใช้เป็นแนวทางประกอบการพิจารณา Applicability ในบทความนี้ ไม่ใช่ GRADE Framework สำหรับ Decision Intelligence
GRADE — Indirectness of Evidence →
Population · Intervention · Comparator · Outcome · Applicability
MEASUREMENT LAYERS
Metric ที่ดีขึ้นไม่ได้ยืนยันว่า Decision หรือ Outcome ดีขึ้นเสมอไป การประเมิน Decision Intelligence จึงต้องแยกสิ่งที่วัดในระดับ Model, Interaction, Decision และ Outcome และตรวจสอบหลักฐานที่เชื่อมระหว่างระดับเหล่านั้น
FOUR MEASUREMENT LEVELS
MODEL
ระบบทำงานได้ดีแค่ไหน
Accuracy, Precision, Recall, Calibration, Error Rate หรือ Model Performance อื่น
บอกได้: คุณสมบัติของ Model ภายใต้สิ่งที่ทดสอบ
≠
INTERACTION
มนุษย์ใช้ Output อย่างไร
Understanding, Reliance, Agreement, Override, Time และ Interaction Behavior
บอกได้: Human–AI Interaction เกิดขึ้นอย่างไร
≠
DECISION
การตัดสินใจดีขึ้นหรือไม่
Decision Accuracy หรือ Utility และ Understanding, Confidence, Readiness ตามบริบทการตัดสินใจ
บอกได้: ผลของระบบต่อสิ่งที่กำลังตัดสินใจ
≠
OUTCOME
เกิดผลที่เราสนใจจริงหรือไม่
ผลต่อผู้ใช้ ธุรกิจ องค์กร ต้นทุน ความเสี่ยง หรือ Outcome ปลายทางที่สำคัญ
บอกได้: ผลที่เกิดขึ้นในระดับที่ต้องการสร้างคุณค่า
PROXY METRIC
คือตัวชี้วัดตัวแทนเมื่อ Outcome หลักวัดยาก ช้า หรือมีต้นทุนสูง โดยต้องมีหลักฐานยืนยันว่าสัมพันธ์กับ Target Outcome จริง
ILLUSTRATIVE EXAMPLE · AI DECISION SUPPORT
Model
Prediction Accuracy สูงขึ้น
Interaction
ผู้ใช้ยอมรับ Recommendation มากขึ้น
Decision
ยังต้องตรวจว่าการตัดสินใจสุดท้ายดีขึ้นจริงหรือไม่
Outcome
ยังไม่สามารถสรุป Business หรือ User Outcome หากยังไม่ได้วัดผลระดับนั้น
เพิ่มเติม: ทำไม Model Accuracy อาจไม่เท่ากับ Human–AI Team Performance
Bansal และคณะศึกษาการทำงานร่วมกันระหว่างมนุษย์กับ AI และแสดงให้เห็นว่า AI ที่มี Accuracy สูงที่สุด ไม่จำเป็นต้องเป็น AI ที่ทำให้ Team Performance สูงที่สุด เมื่อมนุษย์ยังต้องพิจารณา Recommendation และรับผิดชอบ Decision สุดท้าย จึงควรประเมินระบบในระดับที่สัมพันธ์กับการใช้งานจริง ไม่ใช่พิจารณา Model Accuracy เพียงอย่างเดียว
Bansal et al. (2021) — Is the Most Accurate AI the Best Teammate? →
AAAI 2021 · Human–AI Team Performance · DOI: 10.1609/aaai.v35i13.17359
HUMAN–AI RESEARCH LENS
การอ่านงานวิจัย Human–AI ต้องตรวจสอบทั้ง Task, AI, Human, Interaction และ Evaluation เพราะความแตกต่างของ Study Setup อาจเปลี่ยนความหมายของผลวิจัย แม้ใช้ AI ที่มีประสิทธิภาพใกล้เคียงกัน
READ THE STUDY SETUP
TASK
กำลังตัดสินใจอะไร
งานศึกษาเป็นการทำนาย จัดอันดับ หรือเลือกทางเลือก และความผิดพลาดมีผลต่อการตัดสินใจอย่างไร
ดูเพิ่ม: Task จำลองใกล้กับ Decision จริงเพียงใด
AI
ระบบให้อะไรกับมนุษย์
ผู้ใช้ได้รับ Prediction, Recommendation, Confidence หรือ Explanation รูปแบบใด
ดูเพิ่ม: Accuracy และ Error Pattern ของ AI เป็นแบบใด
HUMAN
ใครเป็นผู้ตัดสินใจ
ผู้เข้าร่วมมีความรู้ ประสบการณ์ และข้อมูลก่อนรับคำแนะนำจาก AI เพียงใด
ดูเพิ่ม: Human มีสิทธิ Override หรือ Decision Authority แบบใด
INTERACTION
มนุษย์พบ AI เมื่อไร
AI แสดงก่อนหรือหลัง Human Judgment, ให้แก้คำตอบได้หรือไม่ และมี Feedback แบบใด
ดูเพิ่ม: งานวัดเพียงการยอมรับ Advice หรือแยกได้ว่าเมื่อใดผู้ใช้พึ่งพา AI อย่างเหมาะสม
EVALUATION
เปรียบเทียบกับอะไร
Human-only, AI-only, Human+AI, ระบบเดิม หรือ Baseline อื่นที่เกี่ยวข้อง
ดูเพิ่ม: Outcome ที่วัดตรงกับ Claim ที่งานกำลังสรุปหรือไม่
เพิ่มเติม: Appropriate Reliance และความสมจริงของ Human–AI Decision Studies
Raees et al. (2026) ทบทวนงานวิจัย Human–AI Reliance โดยวิเคราะห์ความสมจริงของ Decision Tasks และ Interaction Factors ที่มีผลต่อการพึ่งพา AI พร้อมอภิปรายข้อจำกัดของงานศึกษาและ Trade-off ในการกระตุ้นให้ผู้ใช้พิจารณาคำแนะนำอย่างรอบคอบ
Raees et al. (2026) — Do People Appropriately Rely on AI-Advice? →
CHI 2026 · Human–AI Reliance · Decision-Making Context · DOI: 10.1145/3772318.3791467
EVIDENCE GOVERNANCE
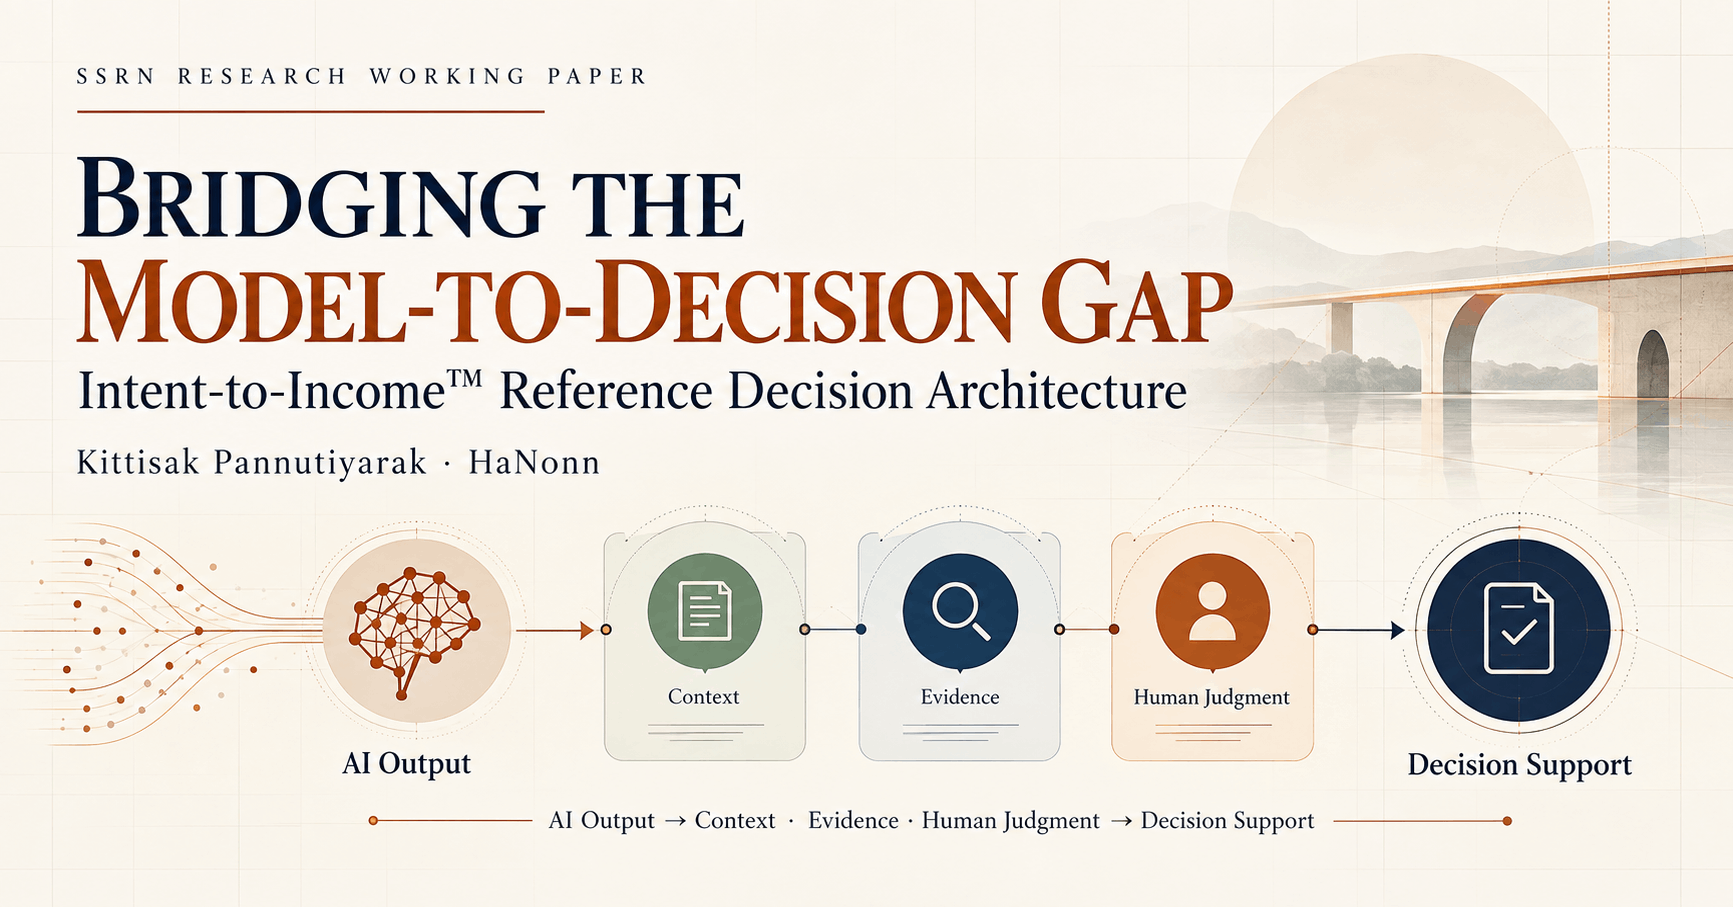
Intent-to-Income™ เป็นตัวอย่างของการแยก Field Knowledge, Research Finding, HaNonn Interpretation และ Proprietary Proposition พร้อมระบุว่าหลักฐานที่มีรองรับข้อสรุปใด และยังไม่รองรับอะไร
KNOWLEDGE & CLAIM GOVERNANCE
FIELD KNOWLEDGE
ความรู้ระดับสาขา
แนวคิด Theory หรือองค์ความรู้ ที่มาจากงานวิจัยและแหล่งภายนอก HaNonn
หลักการ: ไม่เสนอแนวคิดเฉพาะของ HaNonn เสมือนเป็นมาตรฐานของทั้งสาขา
RESEARCH FINDING
สิ่งที่งานวิจัยพบ
รายงานสิ่งที่ Source รองรับจริง พร้อม Method, Population, Task และ Context ที่เกี่ยวข้อง
หลักการ: ไม่ขยาย Claim ไปไกลกว่าสิ่งที่งานศึกษา
HANNONN INTERPRETATION
การตีความของ HaNonn
การตีความและสังเคราะห์ Evidence ของ HaNonn ซึ่งต้องแยกจากข้อค้นพบของงานต้นทาง
หลักการ: แยก Interpretation ออกจาก Research Finding
HANNONN PROPOSITION
ข้อเสนอเฉพาะของ HaNonn
แนวคิดและสถาปัตยกรรมที่ HaNonn พัฒนาขึ้น เช่น Intent-to-Income™ Reference Decision Architecture
หลักการ: ระบุความเป็นเจ้าของและ Evidence Status อย่างตรงไปตรงมา
INTENT-TO-INCOME™ · CURRENT EVIDENCE STATUS
DOCUMENTED & FORMATIVE EVIDENCE
• Published conceptual architecture and design rationale
• Synthetic end-to-end application case
• Internal structured design evaluation and revisions
NOT EMPIRICALLY ESTABLISHED
• Participant behavioral validation
• Validated Decision Quality measures
• Real-world comparative effectiveness
• Causal business impact and independent replication
ข้อมูลเพิ่มเติม: Intent-to-Income™ Research Materials ↓
Conceptual rationale, architecture specification และ design rationale ของ Intent-to-Income™ v1.0
Conceptual synthesis, architecture rationale และ internal formative evaluation; ไม่ใช่ independent empirical validation
Synthetic case และ structured formative evaluation ของ architecture ในสถานการณ์ end-to-end
Persistent research record และ DOI สำหรับ Intent-to-Income™ v1.0
PRACTICAL CHECKLIST
Checklist นี้สังเคราะห์หลักการจากแนวทาง Critical Appraisal และ Evidence-Based Decision-Making เพื่อช่วยตรวจสอบว่า ข้อสรุปสอดคล้องกับหลักฐานเพียงใด และมีข้อจำกัดอะไรบ้าง
Claim
Claim นี้มาจาก Research Finding โดยตรง หรือเป็นการตีความของเรา?
Source
ข้อสรุปนี้ตรวจสอบย้อนกลับไปยัง Original Source ได้หรือไม่?
Method
Research Design ตอบคำถามของ Claim ได้หรือไม่
Measurement
สิ่งที่วัดผลตรงกับ Construct หรือ Outcome ที่กล่าวถึงหรือไม่
Validity
วิธีศึกษาและการวิเคราะห์มีข้อจำกัดต่อข้อสรุปอย่างไร?
Context
Population, Task, Intervention และ Outcome ตรงกับบริบทเป้าหมายเพียงใด?
Boundary
Evidence นี้ยังไม่อนุญาตให้เราสรุปเรื่องใด
Application
หลักฐานนี้ใช้สนับสนุนข้อสรุป หรือเป็นเพียงสมมติฐานที่ต้องทดสอบต่อ?
Methodological Foundation: Checklist นี้สังเคราะห์หลักการจาก Critical Appraisal และ Evidence-Based Decision-Making ที่สอดคล้องกับแนวทางของ CASP, JBI, GRADE และ CEBMa เพื่อใช้ประกอบการเรียนรู้ ไม่ใช่เครื่องมือที่ได้รับการรับรองจากองค์กรเหล่านี้ หรือทดแทนการประเมินเฉพาะ Research Design
Unknown เป็นคำตอบที่ยอมรับได้
หากข้อมูลไม่เพียงพอที่จะประเมินบางข้อ ควรระบุว่า Unknown หรือ Not Established แทนการเติมข้อสรุปจาก Assumption
01 Statistical Significance หมายความว่าผลนั้นสำคัญต่อการตัดสินใจจริงหรือไม่?
ไม่เสมอไป
02 งานวิจัยหนึ่งชิ้นเพียงพอที่จะยืนยัน Claim หรือไม่?
ขึ้นอยู่กับขอบเขตของ Claim
03 การเผยแพร่ Research Paper หรือมี DOI หมายความว่างานนั้นได้รับการพิสูจน์แล้วหรือไม่?
ไม่จำเป็น